Como organizar a pesquisa sobre crimes reais em um arquivo de caso
Para organizar a pesquisa sobre crimes reais em um arquivo de caso, separe as informações por função, atribua IDs estáveis, conecte os registros por referências cruzadas e vincule cada alegação às suas fontes e localizadores. Preserve também o status atual e o histórico de revisões, para que o arquivo permaneça recuperável e rastreável sem tratar organização ou citação como prova.
Mapa operacional do arquivo de caso
Use esta sequência para transformar a pesquisa em um sistema de registros recuperável, rastreável e atualizável.
- 1. Defina o escopo e as classes de registro Comece pela visão geral do caso e separe pessoas, eventos, alegações, fontes e material de suporte por função.
- 2. Padronize nomes e IDs Use nomes descritivos para recuperação humana e IDs persistentes para referências que não se rompam quando os rótulos mudarem.
- 3. Rastreie alegações até as fontes Registre o texto da alegação, o ID da fonte, o localizador, a relação com a fonte, o status da pesquisa e as questões ainda abertas.
- 4. Cruze os registros por relações documentadas Conecte IDs de pessoas, eventos, alegações, fontes e material de suporte sem duplicar o conteúdo integral de cada registro.
- 5. Atualize sem apagar o estado anterior Altere apenas os registros afetados e preserve o histórico de revisão, o motivo da mudança e a referência que a fundamenta.
- 6. Audite completude e rastreabilidade Confirme que IDs, vínculos, itens não resolvidos, revisões e caminhos de recuperação continuam explícitos e funcionais.
Regra central: separar por função, conectar por ID, preservar a incerteza e manter o histórico.
Um arquivo de caso útil para pesquisa de crimes reais mantém os registros localizáveis, conectados, rastreáveis e atualizáveis, em vez de concentrar tudo em uma pasta indiferenciada.
Cada registro deve ter uma função definida para que a recuperação dependa da estrutura do arquivo de caso, e não de lembrar onde um detalhe específico foi armazenado.
Uma estrutura estável dá a cada pessoa, evento, alegação, fonte e registro de material de suporte um lugar consistente, ao mesmo tempo que permite que informações relacionadas se conectem por meio de um ID de registro ou referência cruzada.
Essas conexões apoiam a rastreabilidade porque uma alegação pode remeter à sua fonte sem exigir que a mesma informação seja copiada em vários registros.
Quando novas informações alteram um status ou interpretação, uma atualização deve ser aplicada ao registro relevante, preservando histórico de revisão suficiente para mostrar o que mudou.
Essa abordagem apoia a continuidade à medida que o arquivo de caso se desenvolve, sem implicar que um registro organizado ou fonte vinculada prove uma alegação.
A organização do arquivo de caso é separada da busca por fontes, verificação de alegações, construção de uma cronologia completa ou auditoria de erros de pesquisa; ela fornece a estrutura na qual os resultados dessas atividades podem ser registrados e recuperados.
O próximo passo prático é então definir a estrutura central de registros que conterá e conectará as informações do arquivo de caso.
Índice
Construir a Estrutura Central do Arquivo de Caso
A arquitetura de registro do arquivo de caso funciona separando a pesquisa em classes de registro distintas, ao mesmo tempo que vincula essas classes por meio de identificadores estáveis.
Nessa estrutura, um núcleo prático consiste em seis classes de registro: a visão geral do caso, o registro de pessoa, o registro de evento, o registro de alegação, o registro de fonte e o registro de material de suporte.
Cada classe de registro armazena informações para uma função organizacional, o que torna a recuperação mais precisa e reduz a necessidade de duplicar o mesmo detalhe em todo o arquivo de caso.
Um ID de registro estável fornece o ponto de referência necessário para a rastreabilidade entre registros relacionados.
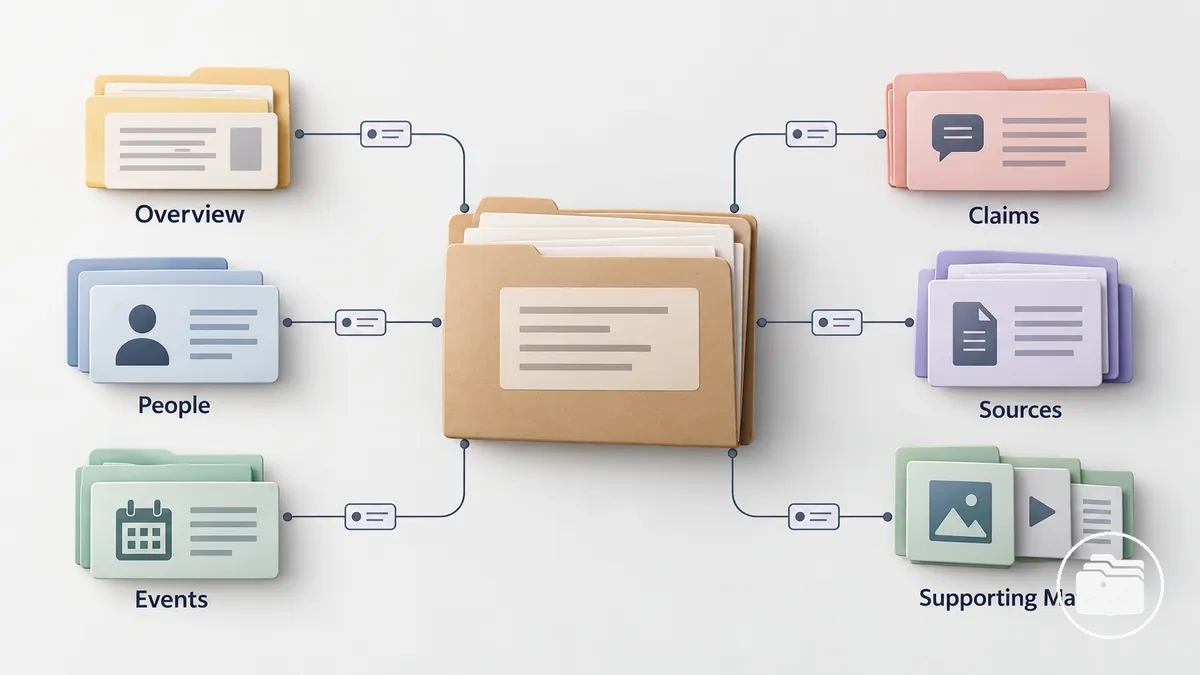
As classes de registro formam um sistema conectado, e não seis coleções isoladas.
A visão geral do caso contém o escopo e o contexto de identificação do arquivo, enquanto as outras classes de registro armazenam pessoas, ocorrências, alegações, fontes ou material de suporte de acordo com sua função.
Referências cruzadas conectam registros relacionados, permitindo que as informações permaneçam separadas por função, mas ainda sejam recuperáveis por meio da estrutura mais ampla do arquivo de caso.
| Classe de registro | O que armazena | Registros vinculados | Finalidade de recuperação ou rastreabilidade |
|---|---|---|---|
| Visão geral do caso | Identidade do caso, escopo e contexto organizacional atual | Pessoas, eventos, alegações, fontes e material de suporte | Fornece a referência comum em nível de caso para o arquivo |
| Registro de pessoa | Informações de identidade e relacionamento documentado | Eventos, alegações, fontes e outros registros de pessoa | Mantém uma referência de pessoa disponível em registros relacionados |
| Registro de evento | Uma ocorrência discreta e seus detalhes registrados de tempo, local ou descrição | Pessoas, alegações, fontes e material de suporte | Permite que a ocorrência seja recuperada e referenciada sem repeti-la em outro lugar |
| Registro de alegação | Uma afirmação específica e seu status ou contexto registrado | Fontes, pessoas, eventos e material de suporte | Permite que a alegação seja rastreada até os registros que a relatam, apoiam, contradizem ou de outra forma se relacionam a ela |
| Registro de fonte | Identidade da fonte e informações de localização | Alegações, eventos, pessoas e material de suporte | Fornece uma referência de fonte estável que vários registros podem reutilizar |
| Registro de material de suporte | Documentos, imagens, arquivos ou outro material retido | Alegações, eventos, pessoas e fontes | Fornece um local recuperável para material associado a outro registro |
Registros vinculados devem referenciar uns aos outros pelo ID de registro, em vez de copiar o conteúdo completo em cada entrada conectada.
Um registro de alegação pode referenciar um registro de fonte, por exemplo, enquanto o registro de fonte permanece o único local que armazena as informações de identificação dessa fonte.
Essa separação mantém cada classe de registro funcionalmente distinta, ao mesmo tempo que preserva a referência cruzada necessária para recuperar material relacionado.
Por exemplo, um registro de evento hipotético E-014 poderia referenciar o registro de pessoa P-003, o registro de alegação C-021 e o registro de fonte S-008 sem reproduzir todos os três registros dentro da entrada do evento.
A estrutura do arquivo de caso organiza esses relacionamentos; encontrar fontes, avaliar alegações, construir a cronologia mais ampla e diagnosticar erros de pesquisa permanecem tarefas de pesquisa separadas.
Visão Geral do Caso e Escopo da Pesquisa
O registro de visão geral do caso é o registro âncora que define o escopo de um arquivo de caso de crime real antes que registros subordinados sejam adicionados.
Ele registra a identidade do caso e as condições que determinam quais pessoas, eventos, alegações e materiais pertencem ao arquivo.
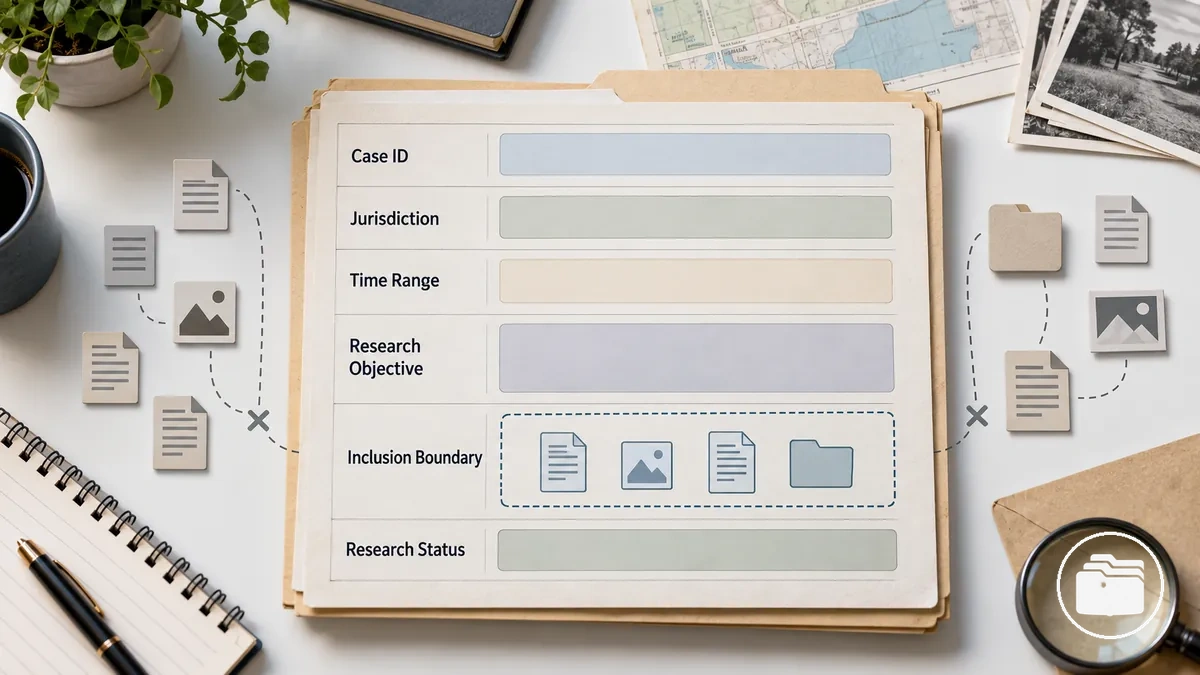
O identificador do caso e a jurisdição estabelecem a identidade do arquivo, enquanto o período de tempo, o objetivo da pesquisa, o limite de inclusão e o status da pesquisa definem seus limites operacionais.
Registrar esses atributos explicitamente faz com que a inclusão dependa do escopo declarado, e não de uma associação vaga com o tópico do caso.
- Identificador do caso: use um identificador estável e específico do caso para que os registros possam ser recuperados e associados ao arquivo correto.
- Jurisdição: registre a jurisdição ou jurisdições relevantes; material fora desse escopo geográfico ou legal pertence ao arquivo apenas quando o objetivo da pesquisa o incluir explicitamente.
- Período de tempo: registre o período coberto pela pesquisa; eventos fora desse período são excluídos, a menos que sejam necessários para entender um evento ou condição incluída.
- Objetivo da pesquisa: declare a pergunta específica ou finalidade informacional que o arquivo deve apoiar; os registros devem contribuir diretamente para esse objetivo.
- Limite de inclusão: declare quais pessoas, eventos, alegações e material se qualificam para inclusão e quais informações relacionadas permanecem fora do arquivo.
- Status da pesquisa: registre o estado atual do arquivo, como ativo, pausado ou encerrado para o objetivo de pesquisa atual, para que atualizações posteriores possam ser interpretadas no contexto correto.
Por exemplo, se um arquivo cobre eventos dentro de uma jurisdição e período de tempo definidos, uma pessoa ou evento associado fora desses limites não entra no arquivo meramente por estar conectado ao mesmo tópico do caso; é necessário um motivo documentado dentro do objetivo da pesquisa ou do limite de inclusão.
A visão geral do caso, por conseguinte, controla a inclusão e exclusão em vez de servir como um resumo narrativo do caso.
Registros de Pessoas e Relacionamentos
Um registro de pessoa identifica cada indivíduo relevante uma vez e mantém os atributos de identidade documentados e os links de registro dessa pessoa em um só lugar.
O registro de pessoa pode, então, conectar o indivíduo a um papel, relacionamento, evento, alegação ou fonte sem repetir o perfil de identidade completo em cada registro vinculado.
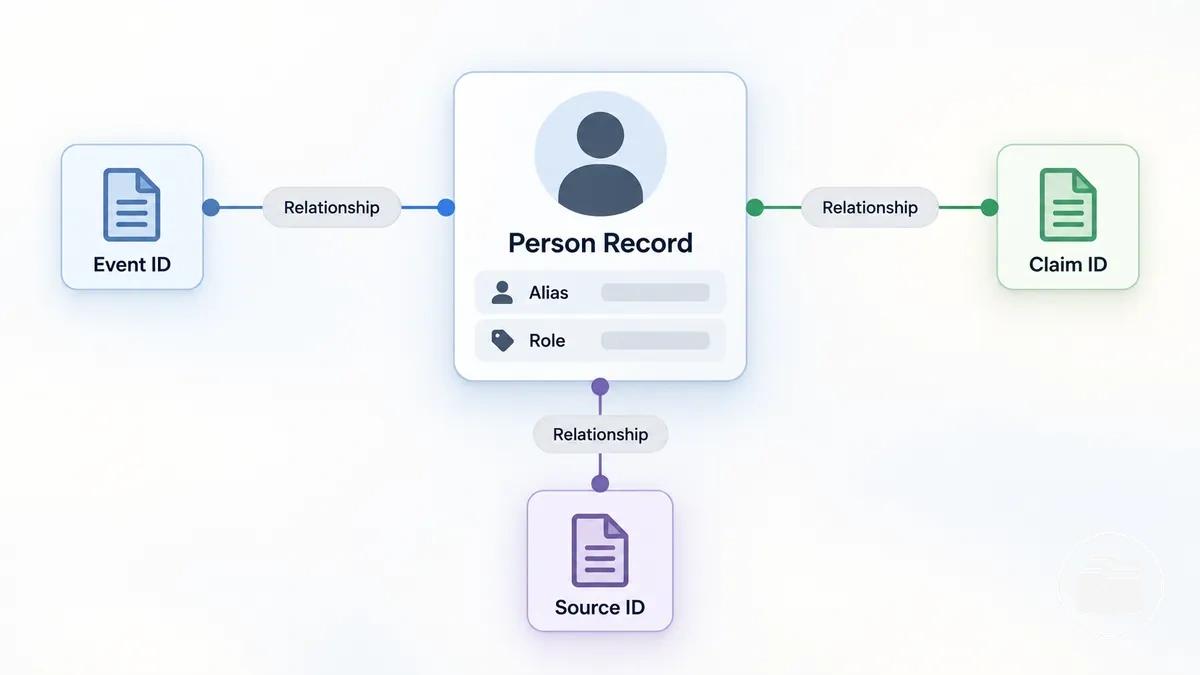
O nome canônico fornece a identidade de trabalho principal para o registro, enquanto cada pseudônimo deve permanecer registrado separadamente quando o material de pesquisa usar outro nome.
Um papel ou relacionamento deve registrar o valor ou status documentado pela fonte relevante, incluindo um status incerto ou contestado quando o material não permitir uma única descrição estabelecida.
Um relacionamento registrado é, portanto, um estado de relacionamento documentado, não uma inferência sobre motivo, culpa ou status legal.
IDs de registro estáveis e referências à fonte conectam esses atributos de identidade aos registros nos quais eles são relevantes.
- Nome canônico: registre o nome de trabalho principal usado para identificar a pessoa consistentemente em todo o arquivo de caso.
- Pseudônimo: registre cada nome ou grafia alternativa documentada separadamente e retenha a incerteza quando um pseudônimo for contestado ou não totalmente estabelecido.
- Papel: registre o papel atribuído à pessoa pelo material relevante, com seu status qualificado quando fontes diferentes descrevem esse papel de forma distinta.
- Relacionamento: registre o tipo de relacionamento documentado e seu status, em vez de inferir uma relação pessoal, legal ou causal não declarada.
- IDs de registros relacionados: faça referência cruzada aos IDs de registro de evento, alegação, pessoa ou outros conectados ao indivíduo em vez de copiar esses registros para o registro de pessoa.
- Referências à fonte: retenha a referência à fonte que apoia cada atributo de identidade, papel ou relacionamento material, para que seu status documentado permaneça rastreável.
Por exemplo, um registro de pessoa hipotético P-003 poderia referenciar o evento E-014, a alegação C-021 e a fonte S-008 mantendo o nome canônico, pseudônimos, função e relacionamentos documentados da pessoa apenas em P-003.
Essas referências cruzadas conectam o indivíduo a vários registros sem criar perfis de pessoa duplicados em todo o arquivo de caso.
Registros de Evento e Referências de Linha do Tempo
Um registro de evento armazena uma ocorrência discreta com seu próprio ID de evento, estado de data ou hora, local, descrição do evento e referências a registros relacionados.
O registro de evento pode vincular a ocorrência a uma pessoa, alegação, fonte ou material de suporte sem copiar esses registros para a entrada do evento.
Uma referência à fonte deve permanecer anexada aos detalhes registrados para que os atributos do evento e sua incerteza possam ser rastreados até o material do qual foram extraídos.
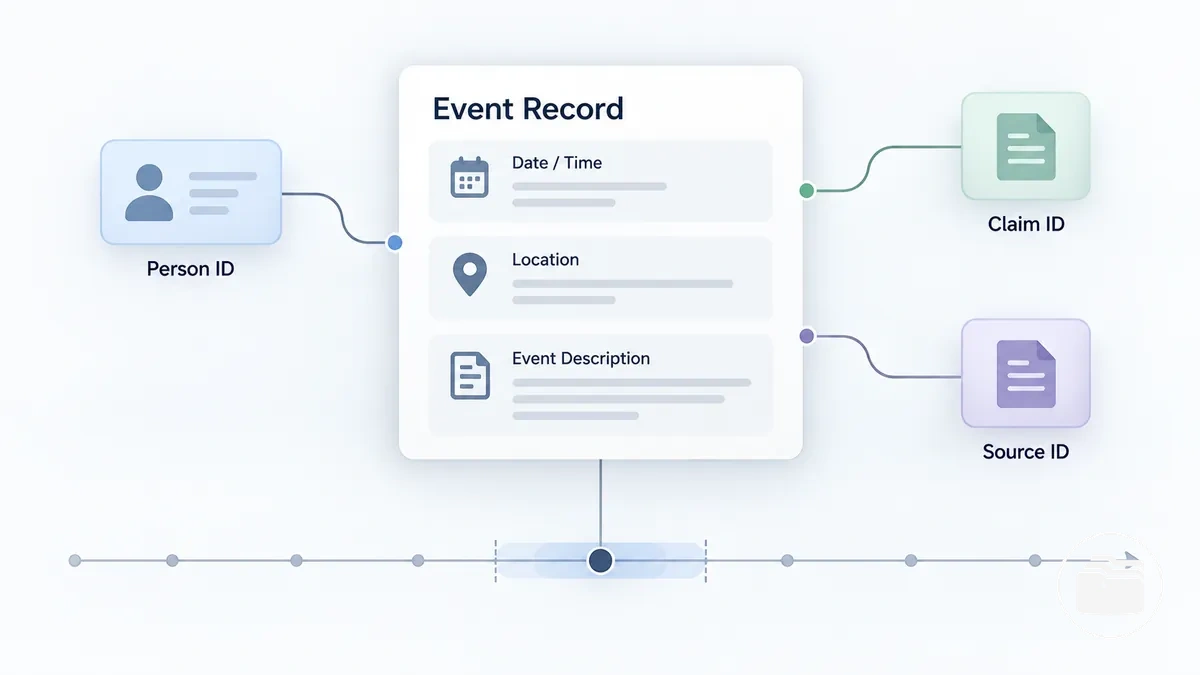
O atributo de data ou hora deve declarar seu nível de precisão temporal em vez de apresentar informações incertas como exatas.
Um estado exato registra uma data ou hora específica documentada pela referência de fonte, um estado aproximado indica que a ocorrência é situada perto de um ponto no tempo relatado, um estado de intervalo registra um período delimitado, e um estado desconhecido indica que o material disponível não permite estabelecer uma data ou hora utilizável.
Esses estados afetam o quão confiantemente o evento pode posteriormente ser posicionado em ordem cronológica, preservando a incerteza registrada no próprio evento.
| Estado temporal | Condição registrada | Implicação na linha do tempo |
|---|---|---|
| Exato | Uma data ou hora específica é documentada pela referência de fonte registrada | O evento pode ser colocado naquele ponto declarado em ordem cronológica |
| Aproximado | A data ou hora é relatada apenas aproximadamente | A referência de linha do tempo deve reter essa aproximação em vez de implicar um posicionamento exato |
| Intervalo | A ocorrência é delimitada entre dois limites temporais registrados | O evento pode ser colocado dentro desse intervalo sem atribuir uma data ou hora exata que não esteja documentada |
| Desconhecido | O registro disponível não estabelece uma data ou hora utilizável | O evento permanece não posicionado cronologicamente até que um valor temporal apoiado se torne disponível |
Um registro de evento e uma linha do tempo do caso têm, portanto, funções distintas: o registro de evento armazena a ocorrência e seus atributos, enquanto uma referência de linha do tempo posiciona aquele evento entre outros eventos de acordo com a informação temporal disponível.
Por exemplo, o registro de evento E-014 poderia reter um estado temporal de intervalo, local, descrição do evento, IDs de registros relacionados e referência à fonte mesmo que a linha do tempo mais ampla não possa atribuir a ele uma única posição exata.
Esta seção registra dados do evento e sua precisão temporal sem reconstruir ou resolver a cronologia mais ampla.
Registros de Alegação e Fonte
Um registro de alegação e um registro de fonte devem permanecer separados, mas vinculados, para que cada declaração possa ser rastreada até o material associado a ela.
O registro de alegação armazena a alegação e seu ID de alegação, enquanto o registro de fonte armazena as informações de identificação da fonte sob um ID de fonte.
O vínculo alegação-fonte registra então a localização relevante da fonte e o status do relacionamento sem tratar a existência de uma citação como prova.
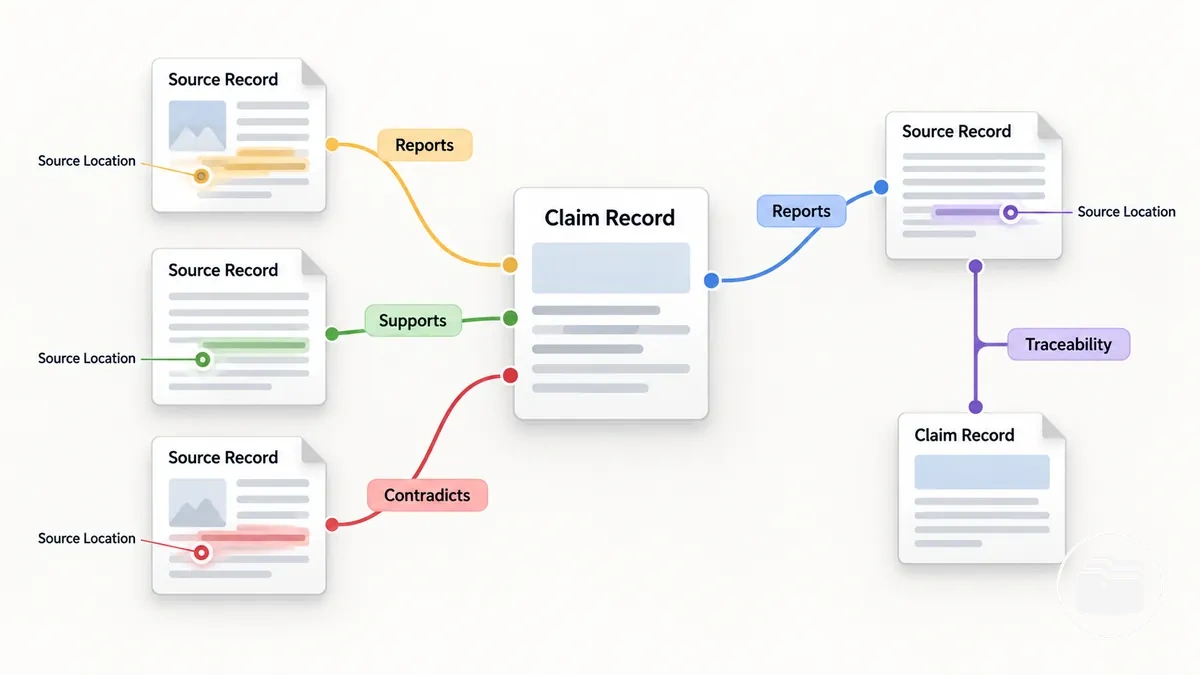
Uma localização na fonte deve identificar a parte precisa do material relevante para a alegação, como uma página, seção, marca de tempo ou outro localizador disponível.
O tipo de relação distingue material que apenas relata uma alegação daquele registrado como apoio, contradição ou outro contexto relevante.
Uma fonte que relata uma alegação não necessariamente a apoia; o tipo de relação registra o papel daquela fonte em relação à alegação.
Manter essa distinção explícita melhora a rastreabilidade sem fazer um julgamento separado sobre a confiabilidade geral da fonte.
| ID da Alegação | Texto da alegação | ID da fonte e localização na fonte | Relação com a alegação | Observações |
|---|---|---|---|---|
| C-021 | Alegação hipotética A | S-008, localizador específico registrado na fonte | Relata | A fonte contém a alegação, mas o vínculo por si só não estabelece apoio |
| C-021 | Alegação hipotética A | S-012, localizador específico registrado na fonte | Apoia | Uma segunda referência de fonte está vinculada à mesma alegação |
| C-022 | Alegação hipotética B | S-008, localizador separado registrado na mesma fonte | Contradiz | O mesmo registro de fonte pode vincular-se a mais de uma alegação |
Essa relação hipotética muitos-para-muitos permite que uma alegação referencie múltiplas fontes e que um registro de fonte referencie múltiplas alegações sem duplicar qualquer um dos registros completos.
Cada vínculo retém sua própria localização na fonte, tipo de relação e observações relevantes; o resultado organizacional é a rastreabilidade entre alegações e material de fonte, em vez de uma suposição de que uma fonte vinculada prova a alegação.
Registros de Material de Suporte
Um registro de material de suporte cataloga cada item de suporte para que possa ser localizado e conectado à alegação, pessoa ou evento que informa, sem tratar o armazenamento como prova de status factual.
Cada registro deve atribuir ao material um ID de item estável e reter as informações descritivas, de origem, armazenamento, vinculação e proveniência necessárias para a recuperação.
- ID do item: atribua um identificador estável ao material de suporte para que outros registros possam referenciar o mesmo item sem duplicá-lo.
- Tipo de material e data: registre o tipo de material e qualquer data documentada de criação, publicação, captura ou recebimento, retendo a incerteza quando a data não estiver estabelecida.
- Origem: registre a origem do item ou a parte, coleção, sistema ou local documentado de onde foi obtido.
- Descrição e status: descreva o que é o item e registre qualquer status organizacional conhecido sem implicar autenticidade, admissibilidade ou verdade factual.
- Nota de proveniência: documente a proveniência disponível, nota da fonte, histórico de transferência ou incerteza necessária para entender a origem e o contexto registrados do item.
- Local de armazenamento: registre o local físico ou digital necessário para recuperar o item, evitando cópias duplicadas desnecessárias.
- IDs de registros relacionados: vincule o material de suporte à alegação, pessoa, evento ou outro registro relevante por meio de seu ID de registro relacionado.
O registro de material de suporte, portanto, organiza a identidade, origem, local de armazenamento, IDs de registros relacionados, proveniência e status de um item, mantendo esses atributos separados de conclusões sobre o que o material estabelece.
Usar Convenções de Nomenclatura e IDs de Registro Consistentes
Uma convenção de nomenclatura consistente e um sistema estável de IDs de registro tornam os registros mais fáceis de recuperar, classificar, cruzar e atualizar sem depender da memória.
Um nome de arquivo pode permanecer descritivo para recuperação humana, enquanto um ID de registro atua como o identificador estável que deve continuar referenciando o mesmo registro mesmo quando os nomes descritivos mudam.
Configure ambas as partes do sistema em uma sequência fixa para que as mesmas regras possam ser aplicadas a registros novos e existentes.
O separador exato, o estilo de capitalização, o formato de data e os campos descritivos podem variar, mas a consistência e a portabilidade devem orientar a escolha.
- Escolha os campos descritivos. Inclua apenas atributos que distinguem materialmente o registro, como assunto, tipo de registro, data, sequência ou versão. Verifique: cada campo selecionado deve ajudar a distinguir ou recuperar o arquivo em vez de adicionar texto redundante.
- Defina a ordem dos campos e o separador. Coloque os campos escolhidos em uma ordem repetível e use um separador consistente, como um hífen ou sublinhado, que funcione de forma confiável no ambiente de armazenamento pretendido. Verifique: nomes de arquivo comparáveis devem exibir os mesmos campos na mesma ordem.
- Padronize a notação de data e versão. Escolha um formato de data e um padrão de versão quando esses atributos forem relevantes; por exemplo, um sistema pode usar AAAA-MM-DD para datas e v01, v02, v03 para versões sucessivas. Verifique: o mesmo tipo de data ou versão não deve aparecer em formatos concorrentes no mesmo sistema de nomenclatura.
- Atribua um ID de registro persistente. Dê a cada registro um identificador estável único que não dependa de seu nome de arquivo descritivo, como EV-014 para um registro de evento. Verifique: alterar um rótulo de assunto, descrição de data ou versão do arquivo não deve exigir a alteração do ID do registro.
- Aplique e verifique a convenção. Use a convenção de nomenclatura e o ID de registro juntos sempre que um registro for criado, renomeado, referenciado de forma cruzada ou atualizado. Verifique: confirme se o nome do arquivo segue o padrão escolhido e se cada referência cruzada ainda aponta para o mesmo ID estável.
Campos descritivos podem mudar quando um rótulo de assunto mais claro, data corrigida ou nova versão tornar o nome do arquivo mais útil, mas o ID do registro deve permanecer persistente para que as referências existentes não precisem ser reescritas.
Por exemplo, um padrão hipotético de nome de arquivo poderia ser caso-a-evento-nota-2025-04-12-v02.txt, usando assunto, tipo de registro, data e versão separados por hífens, enquanto o ID de registro independente poderia permanecer EV-014.
Esses exemplos ilustram uma estrutura funcional, e não um padrão universal; o requisito fundamental é a execução consistente em todo o arquivo de caso.
Manter Nomes de Arquivo Descritivos, Consistentes e Fáceis de Recuperar
Um nome de arquivo descritivo deve identificar e agrupar um arquivo sem exigir que ele seja aberto.
Inclua apenas campos estáveis e significativos que ajudem a distinguir o registro e aplique o mesmo padrão de nomenclatura de forma consistente para que a recuperação não dependa de lembrar um nome de arquivo individual.
Selecione os campos de acordo com o que os usuários precisam examinar ou classificar; em seguida, mantenha sua ordem previsível em arquivos comparáveis.
Use um separador de forma consistente, em vez de tratar qualquer caractere como obrigatório, e mantenha o formato de data e a notação de versão consistentes quando esses campos distinguirem materialmente os registros.
Quando arquivos forem transferidos entre sistemas, caracteres simples legíveis por máquina e caracteres especiais limitados podem melhorar a portabilidade, sujeito aos requisitos desses sistemas.
Evite nomes que se tornem excessivamente longos ou repitam informações que não melhorem a identificação ou recuperação.
- Identificador do caso: inclua-o quando o arquivo precisar ser agrupado com outro material do mesmo caso, dando a arquivos relacionados uma identidade compartilhada durante a recuperação.
- Assunto: use um rótulo conciso de pessoa, tópico, local ou outro assunto quando ele distinguir materialmente o arquivo de registros semelhantes no mesmo caso.
- Tipo de material: identifique o conteúdo do registro, como uma nota de entrevista, imagem, transcrição ou documento, para que os arquivos possam ser agrupados por função sem abri-los.
- Data: inclua uma data quando a classificação cronológica ou a identificação dependerem dela e use um formato de data consistente dentro da convenção de nomenclatura.
- Versão: use um valor de versão claro quando formas sucessivas do mesmo arquivo devem permanecer distinguíveis; uma versão como v02 é mais informativa do que um rótulo ambíguo como final.
- Separador e caracteres: use um separador previsível e um conjunto de caracteres legível que funcione nos sistemas de armazenamento pretendidos, evitando caracteres especiais desnecessários que possam reduzir a portabilidade.
Para a mesma nota de entrevista hipotética, CASE-A_pessoa-x_nota-de-entrevista_2026-03-14_v02.docx é mais fácil de identificar, classificar e recuperar porque seu identificador do caso, assunto, tipo de material, data e versão são explícitos.
Um nome mais fraco, como pessoa-x-notas-final.docx, omite o identificador do caso e a data, deixa o tipo de material menos preciso e usa um rótulo de versão que não indica seu lugar em uma sequência.
Atribuir IDs Estáveis para Referências Cruzadas
Um ID de registro estável fornece a cada registro um identificador persistente que permanece inalterado quando seu nome de arquivo, rótulo descritivo ou outros detalhes editáveis mudam.
Manter esse identificador estável permite que pessoas, eventos, alegações, fontes e material de suporte mantenham referências cruzadas confiáveis durante atualizações e manutenção futuras.
Regras de um ID estável
- Unicidade
- Cada ID deve ser único dentro do sistema definido; um novo registro não deve reutilizar um identificador existente.
- Prefixo opcional
- Prefixos de classe, como
Ppara pessoa ouEVpara evento, podem ajudar na leitura, mas não devem incorporar metadados mutáveis que forcem a troca do ID. - Controle de colisão
- A regra de atribuição deve verificar identificadores já usados antes de criar um novo, evitando que dois registros recebam o mesmo ID.
Por exemplo, um registro de evento hipotético poderia usar EV-014, enquanto o registro de alegação C-021 armazena EV-014 como sua referência cruzada; o identificador aponta para o registro vinculado, mas não comprova, valida, classifica nem estabelece o valor probatório de seu conteúdo.
Rastrear Cada Alegação, Sua Fonte e Seu Status de Pesquisa
Um registro de alegações documenta o que está sendo afirmado, de onde veio a alegação e seu status atual de pesquisa, mantendo recuperável o caminho até a fonte subjacente.
Cada alegação deve ter seu próprio ID de alegação vinculado ao ID de fonte relevante e à localização na fonte, para que uma revisão posterior possa retornar ao material exato por trás da entrada.
O registro apoia a rastreabilidade e o acompanhamento, em vez de tratar um rótulo de status como uma declaração de verdade final.
Para cada alegação, registre o texto conciso da alegação, o ID ou IDs de fonte vinculados, a localização precisa na fonte disponível para cada referência, o status atual da pesquisa, qualquer questão não resolvida e a data da última revisão.
Um status de pesquisa deve descrever uma condição documentada: por exemplo, não resolvida quando o material disponível ainda não permite uma avaliação clara, apoiada quando o material vinculado dá suporte à alegação registrada, ou contraditada quando o material vinculado entra em conflito com ela.
Cada estado deve levar a uma ação de acompanhamento explícita, em vez de implicar certeza apenas pelo rótulo.
O registro de alegações pode, portanto, expor tanto o estado atual quanto o trabalho de pesquisa restante.
| ID da Alegação | Texto da alegação | ID da fonte e localização | Status da pesquisa | Questão não resolvida | Última revisão | Acompanhamento |
|---|---|---|---|---|---|---|
| C-031 | Alegação hipotética sobre um detalhe de evento | S-014, localizador de página ou seção registrado | Não resolvida | Apenas uma fonte de relato está atualmente vinculada | 2026-09-28 | Localizar material adicional relevante e revisar a alegação novamente |
| C-032 | Alegação hipotética com material de suporte vinculado | S-018 e S-022, localizadores registrados separados | Apoiada | Nenhuma contradição específica está registrada atualmente | 2026-09-29 | Manter o vínculo com as fontes e revisar se novo material altera a condição documentada |
| C-033 | Alegação hipotética com material conflitante | S-025, localizador registrado | Contraditada | O material vinculado conflita com a afirmação registrada | 2026-09-29 | Sinalizar o conflito para revisão adicional sem reescrever o histórico anterior do registro |
Quando novas informações alteram a condição documentada de uma alegação, atualize seu status atual de pesquisa mantendo a revisão anterior para que o estado prévio permaneça recuperável.
Por exemplo, uma alegação hipotética pode passar de não resolvida para apoiada após um segundo ID de fonte e localização precisa na fonte serem adicionados, enquanto a entrada anterior não resolvida permanece parte do histórico de revisão.
A data da última revisão e a questão não resolvida devem ser atualizadas ao mesmo tempo para que o próximo acompanhamento reflita o estado mais recente do registro.
Isso preserva a rastreabilidade ao longo das mudanças de status sem apresentar o registro em si como um método de verificação.
Conectar Cada Alegação às Suas Fontes e Localizadores
Cada vínculo entre alegação e fonte deve conectar um ID de alegação ao ID de fonte exato e, quando disponível, a um localizador preciso na fonte, como página, parágrafo, marca de tempo, entrada de registro ou outro local recuperável.
Registrar tanto a referência da fonte quanto o localizador dá a outro leitor um caminho direto de volta ao material relevante, melhorando a recuperação, revisão e rastreabilidade sem tratar a citação em si como verificação.
- Relatada por: use esta relação de relato quando a fonte contiver ou repetir a alegação, sem implicar que a fonte apoie independentemente sua exatidão.
- Apoiada por: use esta relação quando a fonte contiver material que apoie a alegação registrada sob as condições atuais de pesquisa.
- Corroborada entre fontes: use esta relação somente quando múltiplos registros de fonte apoiarem independentemente a mesma afirmação relevante; se uma fonte entrar em conflito com ela, registre essa fonte como contradizente em vez de ocultar a discordância.
Por exemplo, a alegação hipotética C-041 poderia apontar para a fonte S-017 na página 12, parágrafo 3, com a relação Relatada por, enquanto a fonte S-024 aponta para a marca de tempo 00:18:42 com a relação Apoiada por.
Se ambas as fontes derem suporte independente à mesma alegação, o registro pode anotar a corroboração entre esses vínculos; se S-024 entrar em conflito com a alegação, marque esse vínculo como Contradiz, enquanto a relação Relatada por de S-017 permanece intacta.
Manter cada ID de fonte, localizador de fonte e tipo de relação separados preserva a rastreabilidade de concordância e conflito sem transformar a vinculação de fonte em um julgamento de qualidade da fonte.
Registrar Informações Não Resolvidas e Lacunas de Pesquisa Separadamente
Um registro de informações não resolvidas deve manter cada questão não resolvida ou lacuna de pesquisa separada das anotações de caso estabelecidas, para que a incerteza permaneça visível em vez de ser absorvida pela narrativa do caso.
Use-o para um relato conflitante, registro ausente, data incerta, associação não verificada ou outra questão em aberto, e vincule o item a cada alegação, evento, pessoa ou fonte afetada por meio de seu ID de registro relacionado.
Informação ausente significa que o registro não está disponível no momento, o que é diferente de evidência de que o registro ou evento não existiu.
Cada registro de lacuna deve identificar o que é conhecido, por que a questão permanece não resolvida, qual evidência é necessária e a próxima ação de pesquisa que poderia alterar seu status.
Um status de informação ausente indica que o material necessário não foi localizado, um status de informação conflitante registra relatos ou registros incompatíveis, e um status incerto indica que a informação disponível permite mais de uma interpretação ou nível de precisão.
Essas classificações documentam a condição presente sem converter especulação em fato ou tratar um status não resolvido como uma conclusão.
| ID da lacuna | Questão não resolvida | IDs de registros relacionados | Motivo de não resolução | Status | Evidência necessária | Próxima ação de pesquisa |
|---|---|---|---|---|---|---|
| G-012 | Data do evento hipotético ainda não pode ser posicionada com precisão | E-014, C-041 | Dois registros vinculados fornecem datas diferentes | Informação conflitante | Um registro datado ou outra fonte que esclareça a data do evento | Revisar material datado adicional conectado a E-014 |
| G-013 | Documento hipotético referenciado não foi localizado | C-044, S-027 | A fonte menciona o documento, mas o documento em si não está disponível no arquivo atual | Informação ausente | O documento referenciado ou um registro confiável de seu conteúdo e origem | Rastrear a referência por meio do registro de fonte vinculado e atualizar a lacuna se o documento for encontrado |
| G-014 | Associação hipotética entre dois registros permanece incerta | P-006, E-019 | O material disponível mostra uma conexão possível, mas não estabelece sua natureza | Incerto | Material adicional que esclareça se e como os registros estão relacionados | Manter a associação qualificada e revisar o material recém-vinculado |
Por exemplo, uma questão em aberto sobre a data do evento E-014 pode permanecer sob o ID de lacuna G-012 enquanto também vincula à alegação C-041, permitindo que ambos os registros mostrem que a data ainda não está resolvida.
Se material posterior resolver o conflito, atualize o status da lacuna e retenha a condição anterior para que a mudança permaneça rastreável.
O status deve mudar apenas quando novas informações justificarem uma condição documentada diferente.
Referenciar de Forma Cruzada Pessoas, Eventos, Alegações e Material de Suporte
Uma referência cruzada conecta registros distintos para que um pesquisador possa ir de uma pessoa, evento, alegação ou fonte aos registros diretamente relacionados sem duplicar seu conteúdo completo.
Cada vínculo deve usar o ID de registro relevante e um rótulo de relação explícito que indique como os dois registros estão conectados.
Isso preserva a função separada de cada registro, ao mesmo tempo que torna o arquivo de caso mais fácil de navegar, recuperar e revisar.
Uma referência cruzada deve ser baseada em um relacionamento documentado, e não em similaridade, conveniência narrativa ou associação inferida.
Use IDs de registro estáveis como os pontos finais de cada referência cruzada e escolha um rótulo de relação que descreva a conexão armazenada com precisão, como pessoa envolvida, evento relacionado, apoia alegação, contradiz alegação ou derivado da fonte.
Quando a estrutura do arquivo permitir, uma referência bidirecional pode fazer com que cada registro vinculado aponte de volta para o outro, reduzindo o atrito de recuperação durante revisões posteriores.
O vínculo reverso deve descrever o mesmo relacionamento documentado a partir da perspectiva apropriada do registro, em vez de inventar uma segunda relação.
Se um registro for atualizado, os IDs estáveis permitem que a referência permaneça intacta sem copiar o conteúdo alterado para cada registro vinculado.
| ID do registro de origem | Rótulo da relação | ID do registro de destino | Implicação para recuperação |
|---|---|---|---|
| P-006 | Evento relacionado | E-019 | O registro de pessoa pode recuperar a conexão do evento documentado sem duplicar o registro de evento |
| E-019 | Alegação relacionada | C-044 | O registro de evento pode recuperar a alegação associada àquela ocorrência |
| C-044 | Derivado da fonte | S-027 | A alegação pode ser rastreada até o registro de fonte do qual a declaração ou material registrado foi extraído |
Nesta cadeia hipotética, a pessoa P-006 vincula-se ao evento E-019, o evento vincula-se à alegação C-044 e a alegação vincula-se à fonte S-027.
Cada relação permanece explícita e revisável separadamente, para que outro pesquisador possa seguir a cadeia em qualquer direção documentada sem tratar a proximidade entre registros como prova de culpa, causalidade ou qualquer associação não documentada.
O resultado é uma rastreabilidade e recuperação mais fortes, mantendo os registros subjacentes auditáveis e não duplicativos.
Manter o Arquivo de Caso Atualizado Conforme a Pesquisa Muda
Uma rotina de atualização do arquivo de caso deve aplicar novas informações apenas a cada registro afetado, mantendo o estado anterior recuperável.
Trate cada atualização de manutenção como uma revisão controlada: identifique o que mudou, qual ID de registro é afetado, qual se torna o estado revisado e o motivo documentado para essa alteração.
- Receba as novas informações: registre o novo material e identifique a alegação, evento, lacuna, fonte ou relacionamento específico que pode ser afetado. Verifique: confirme que o material foi associado ao caso correto antes de alterar qualquer registro existente.
- Identifique os IDs de registro afetados: liste cada registro afetado antes de editar para que a atualização permaneça limitada a registros cujos atributos ou relacionamentos possam mudar. Verifique: registros não relacionados devem permanecer fora do escopo da revisão.
- Atualize ou adicione o registro necessário: revise o atributo ou relacionamento afetado, ou adicione um novo registro quando as novas informações representarem uma entidade, evento, alegação, fonte ou item de suporte genuinamente distinto. Verifique: preserve o estado anterior para que a condição anterior do registro permaneça recuperável.
- Revise o status da alegação ou lacuna: revise um status apenas quando as novas informações justificarem uma condição documentada diferente; caso contrário, retenha a incerteza existente. Verifique: o estado revisado deve corresponder às informações disponíveis, em vez de assumir resolução.
- Atualize as referências cruzadas: atualize a referência cruzada relevante quando as novas informações alterarem a forma como os registros se relacionam entre si. Verifique: cada vínculo afetado ainda deve apontar para o ID de registro e relacionamento corretos.
- Registre a revisão: documente o estado anterior, o estado revisado, os IDs de registro afetados e o motivo documentado para a alteração. Verifique: outro revisor deve ser capaz de distinguir as novas informações da interpretação anterior sem reconstruir o arquivo inteiro.
Por exemplo, uma fonte recém-encontrada pode justificar a revisão do status de uma alegação e a adição de uma nova referência a um evento, deixando pessoas, alegações e registros de material de suporte não relacionados inalterados.
A verificação de manutenção, logo, não é se todo o arquivo de caso mudou, mas se cada registro afetado reflete as novas informações, preserva seu estado anterior e mantém referências cruzadas consistentes.
Registrar Revisões Sem Sobrescrever Estados de Pesquisa Anteriores
Um registro de revisão preserva o histórico de um registro documentando o que mudou, quando a mudança foi feita e a base documentada para a revisão, mantendo o estado anterior.
Isso permite que uma revisão posterior reconstrua a sequência de correções e mudanças de status sem assumir que o registro fornece salvaguardas além da forma como o arquivo de caso é mantido.
| Data da revisão | ID do registro | Atributo alterado | Estado anterior | Novo estado | Motivo | Referência da fonte |
|---|---|---|---|---|---|---|
| 2026-09-30 | E-014 | Data do evento | 2026-04-12 | 2026-04-13 | Fonte hipotética recém-revisada registra uma data diferente | S-032, localizador registrado |
Cada entrada de revisão deve identificar a data da revisão e o ID do registro, nomear o atributo alterado, preservar o estado anterior, registrar o novo estado e documentar o motivo e a referência da fonte que apoiam a alteração.
O valor ou status anterior deve permanecer recuperável para que outro revisor possa distinguir o estado de pesquisa anterior da correção posterior.
Neste exemplo hipotético, o registro de evento E-014 retém sua data registrada anterior, enquanto o histórico de revisão mostra que a data do evento mudou porque a fonte S-032 forneceu a base documentada para a correção.
O registro de revisão, portanto, preserva a rastreabilidade mantendo ambos os estados e o motivo da alteração disponíveis para revisão.
Revisar o Arquivo de Caso para Completude e Rastreabilidade
Uma revisão de completude e rastreabilidade do arquivo de caso verifica se o sistema organizacional consegue recuperar registros e rastrear alegações importantes sem depender da memória.
Ela verifica condições estruturais observáveis, como identificadores, vínculos, registros de manutenção e caminhos de recuperação; passar nessas verificações apoia a usabilidade organizacional, em vez de estabelecer a exatidão factual.
Avalie cada condição como aprovada ou como um acompanhamento direcionado.
Uma verificação estrutural reprovada deve identificar o registro específico, o vínculo ausente ou o problema de manutenção que precisa de correção, em vez de reabrir o processo mais amplo de pesquisa ou corroboração.
- IDs estáveis: confirme que cada registro tem um ID estável e que os IDs de registro referenciados ainda resolvem para os registros pretendidos. Aprovado: cada identificador é único e recuperável. Acompanhamento: atribua ou corrija o identificador afetado e repare as referências que apontam para o registro errado.
- Nomes de arquivo consistentes: confirme que arquivos comparáveis seguem o padrão de nome de arquivo consistente estabelecido para o arquivo de caso. Aprovado: nomes de arquivo usam os campos, ordem e notação esperados. Acompanhamento: renomeie apenas os arquivos inconsistentes, preservando seus IDs de registro estáveis.
- Vínculos alegação-fonte: confirme que cada vínculo material de alegação-fonte conecta a alegação ao seu registro de fonte e localizador de fonte disponível. Aprovado: a alegação pode ser rastreada diretamente até o material de fonte vinculado. Acompanhamento: adicione ou repare a referência de fonte ou localizador ausente.
- Pessoas e eventos conectados: confirme que cada relação documentada de pessoa-para-evento, evento-para-alegação ou outra relação de registro conectado usa um rótulo de relação explícito. Aprovado: registros diretamente relacionados podem ser recuperados por meio de seus vínculos documentados. Acompanhamento: adicione a referência cruzada ausente ou corrija um rótulo de relação não documentado.
- Itens não resolvidos: confirme que cada item não resolvido permanece explicitamente marcado com seu status atual, registros relacionados, motivo da incerteza e acompanhamento necessário. Aprovado: a incerteza é visível em vez de incorporada em anotações estabelecidas. Acompanhamento: crie ou atualize o registro de lacuna sem converter a condição não resolvida em uma conclusão factual.
- Histórico de revisão: confirme que alterações materiais estão representadas no registro de revisão com o estado anterior, novo estado, ID do registro, motivo e referência da fonte quando aplicável. Aprovado: estados de pesquisa anteriores permanecem recuperáveis. Acompanhamento: restaure a entrada de revisão ausente ou documente a base da alteração antes de editar novamente.
- Recuperabilidade: confirme que um revisor pode recuperar cada registro importante por meio de seu ID de registro, nome de arquivo ou referência cruzada documentada sem depender da memória pessoal. Aprovado: o caminho de recuperação é explícito e repetível. Acompanhamento: repare o identificador, nome de arquivo, referência de armazenamento ou vínculo de registro que bloqueia a recuperação.
- Registros órfãos: identifique qualquer registro órfão que não tenha conexão documentada com a visão geral do caso ou com outro registro relevante onde tal relação deveria existir. Aprovado: cada registro dentro do escopo tem um lugar justificado na estrutura do arquivo de caso. Acompanhamento: adicione o vínculo documentado ausente, esclareça por que o registro está isolado ou remova-o do arquivo de caso se estiver fora do escopo definido.
Verificações reprovadas devem desencadear correções direcionadas aos registros e vínculos relevantes, em vez de uma reestruturação completa do arquivo de caso.